Google stellt Gemini 4 Argon vor: Neues KI-Spitzmodell mit Fokus auf Coding, Wissensarbeit und Cyber-Abwehr
Veröffentlicht am 30.09.2026

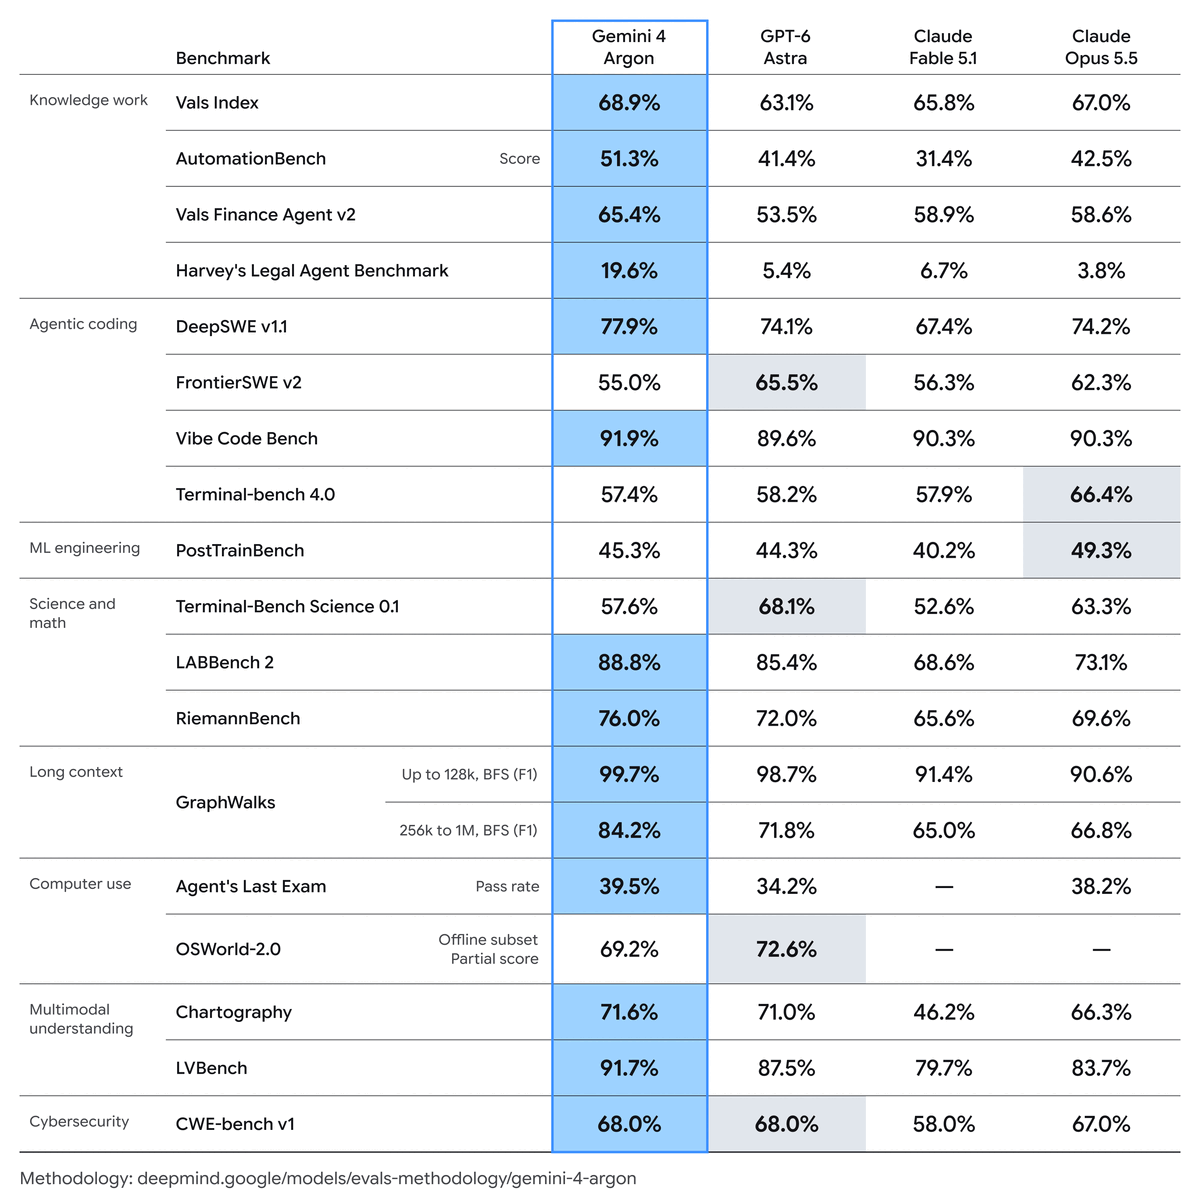
Mit Gemini 4 Argon führt Google sein nächstes Frontier-Modell ein. Es soll anspruchsvolle, langlaufende Aufgaben in realer Softwareentwicklung, in Wissensarbeit etwa in Recht und Finanzen sowie in der Cybersicherheit meistern. Erste Benchmarks unterstreichen den Anspruch: 77,9 Prozent beim DeepSWE-Softwaretest, geteilter erster Platz beim CWE-bench für die Behebung von Sicherheitslücken und die mit Abstand beste Robustheit gegen Prompt-Injection-Angriffe. Der Start erfolgt bewusst gestaffelt – zunächst für ausgewählte Cyber-Verteidiger und Tester.
Google hat Ende September sein neues KI-Spitzenmodell Gemini 4 Argon angekündigt. Das Modell ist darauf ausgelegt, tiefgehende Denkprozesse über lange, mehrstufige Aufgaben hinweg aufrechtzuerhalten – etwa in der realen Softwareentwicklung, in unternehmerischer Wissensarbeit wie Recht und Finanzen sowie in der Cybersicherheit. Die Markteinführung erfolgt bewusst in Etappen: Zunächst erhalten ausschließlich vertraute Cyber-Verteidiger über das Fairwind-Programm Zugriff. Parallel beteiligt sich Google an einem freiwilligen Verfahren der US-Regierung, das ausgewählten Stellen Zugang zu Modellen vor deren breiter Veröffentlichung einräumt. Erst schrittweise sollen Entwickler, Unternehmen und Verbraucher folgen.
Wie Argon die Arbeit bei Google verändert
Laut Google treiben bereits tausende Beschäftigte ihre internen Arbeitsabläufe mit Argon voran – vor allem bei speziellen Programmieraufgaben, tiefergehender Recherche und beim Verfassen von Texten. In mehreren Projekten spielt das Modell schon jetzt eine zentrale Rolle: So hilft Argon Quantenforschenden dabei, die Spacetime-Ressourcen (Qubits × Gatter) von Subroutinen zu optimieren, die wichtige Anwendungen ausbremsen. In einem Beispiel übertraf das Modell den publizierten Basiswert um 40 Prozent – innerhalb von Minuten. Ein Team aus Argon-Agenten analysierte zudem Telemetriedaten aus Googles Rechenzentren und brachte Speicheroptimierungen eigenständig auf den Weg. Bereits ausgerollte Änderungen gaben über 300 TiB Speicher frei; insgesamt werden Ersparnisse von 500 TiB bis zu einem PiB geschätzt.
Besonders weitreichend sind die laufenden Migrationen von C- und C++-Codebasen zu Rust: Argon-Agenten arbeiten an Kernbibliotheken wie re2 und libgav1 mit zehntausenden Zeilen Code ebenso wie am Zircon-Kernel des Betriebssystems Fuchsia mit mehr als 800.000 Zeilen. Wegen der Kritikalität dieser Systeme durchlaufen solche Umschreibungen strenge automatisierte und manuelle Audits, Emulationstests und Reviews, bevor sie in Produktion gehen. Im Fall von libgav1, Googles Open-Source-Software zur Videodekodierung, ersetzte ein Agententeam rund 32.000 Zeilen SIMD-Code mithilfe vieler Runden profilgeleiteter Experimente. Heraus kam ein speichersicherer Videodekoder, der 2,7-mal schneller läuft als der bisherige Rust-Port – bei identischer Videoausgabe und damit näher am optimierten C++-Original.
Eine Million Token in einem Zug
Um längere und komplexere Aufgaben zu unterstützen, weitet Google das Ausgabelimit von bisher 64.000 auf eine Million Token aus – laut Unternehmensangaben ein Branchenrekord. Das Modell erhält damit den Freiraum, in einem einzigen Durchlauf hunderttausende Token zu erzeugen und schwierige Probleme in einem Zug zu lösen.
Führend bei Coding und Wissensarbeit
Google-Entwickler nutzen Argon bereits im Alltag – vom alltäglichen Debugging über großangelegte Codebasismigrationen bis zum Algorithmendesign. In Benchmark-Tests setzt das Modell dabei laut Google neue Maßstäbe: 77,9 Prozent auf DeepSWE v1.1, das die Leistung bei realen, langlaufenden Software-Engineering-Aufgaben misst – ein State of the Art. Auf dem Vals Index, der die wirtschaftliche Wirkung in Finanzen, Coding, Recht und Steuern misst und jeden Sektor nach seinem Beitrag zum US-BIP gewichtet, führt Argon mit 68,9 Prozent. Auch bei domänenspezifischen Prüfungen wie Vals Finance Agent v2 für mehrstufige Finanzrecherche und Harvey's Legal Agent Benchmark für juristische Recherche und Entwürfe liegt es vorn. Auf Zapier AutomationBench, der die End-to-End-Ausführung zentraler Geschäftsfunktionen misst, belegt Argon mit 51,3 Prozent Rang eins.
Auch wenn Wissensarbeit visuelles Verständnis erfordert, zeigt sich Argon stark – etwa bei professionellen Diagrammanalysen, der Detailerkennung in langen Videos oder der Abarbeitung einer Reihe von Dokumenten. Beim LVBench für langes Video-Verständnis erreicht es mit 91,7 Prozent den State of the Art; bei GraphWalks, das Kontexte bis zu einer Million Token umfasst, liegt es mit 84,2 Prozent deutlich vorn.
Cyber-Abwehr als Kernkompetenz
Für die Abwehr der neuen Ära von Cyberangriffen hat Google Argon gezielt zu einem starken Verteidigungsmodell trainiert. Es kann kritische Software-Schwachstellen eigenständig finden, validieren und patchen. Vertrauten Verteidigern und internen Teams will Google Argon sogar ohne Cyber-Schutzschranken zur Verfügung stellen, damit diese die vollen Abwehrfähigkeiten nutzen können.
Der Sicherheitsanbieter Wiz setzt Argon bereits in der Initiative „Scan for Good" ein, die kritische öffentliche Infrastruktur kostenlos schützt, indem hochriskante Schwachstellen gefunden und behoben werden. In einer frühen Demonstration deckte das Modell eine kritische Verwundbarkeit auf, die sensible personenbezogene Daten in weltweit von Krankenhäusern genutzter Software preisgab – ein schwerwiegendes Risiko, das frühere Frontier-Modelle nicht entdeckt hatten.
Auf dem CWE-bench v1, der das Beheben von Sicherheitslücken misst, erreicht Argon mit 68 Prozent den geteilten Spitzenplatz – laut dem Leaderboard gleichauf mit Grok 4.7 und knapp vor GPT-6 Astra mit 67 Prozent. Claude Opus 5.5 (58 Prozent) und DeepSeek-V4 (55 Prozent) liegen deutlich dahinter. Gegenüber Googles Vorgänger 3.8 Flash Cyber, das auf dem Vorgänger-Benchmark CWE-bench v0 bereits Maßstäbe gesetzt hatte, zeigt Argon deutliche Sprünge bei der Schwachstellensuche: Auf einem internen Benchmark von Google deckte es ein breites Spektrum von Verwundbarkeiten in komplexen Codebasen über 20 Programmiersprachen hinweg auf. Auf Wiz' internem Black-Box-Pentest-Benchmark, der Live-Websysteme ohne Zugriff auf den Quellcode analysiert, übertrifft Argon den Vorgänger beim Aufdecken der Angriffsfläche, beim Identifizieren von Schwachstellen und beim Erzeugen von Proof-of-Concept-Nachweisen.

Vier Schutzbereiche vor dem breiten Rollout
Bevor Argon allgemein verfügbar wird, verstärkt Google zentrale Frontier-Schutzmaßnahmen in vier Bereichen:
Missbrauch verhindern: Argon soll schädliche Anfragen im Cyber- sowie im CBRN-Bereich – also zu chemischen, biologischen, radiologischen und nuklearen Risiken – verweigern, legitime Dual-Use-Forschung aber zulassen. Google verbessert dafür Techniken, mit denen sich die inneren Aktivierungen des Modells überwachen lassen, um Missbrauch früh zu erkennen. Interne und externe Red Teams haben die Schutzmaßnahmen mit manuellen und automatisierten Angriffsmethoden auf die Probe gestellt.
Prompt-Injections abwehren: Argon gilt als das bisher widerstandsfähigste Google-Modell gegen indirekte Prompt-Injection-Angriffe, bei denen eingeschleuste Anweisungen oder Kontexte das Verhalten eines Modells kapern. Beim IPI-Benchmark von Gray Swan liegt die Angriffsrate nur bei 0,7 Prozent – Modelle wie Grok 4.6 (51,8 Prozent) oder Kimi K3 (52,7 Prozent) sind um ein Vielfaches anfälliger. Möglich wurde das unter anderem durch automatisiertes Red Teaming und adversarielles Training.

Fehlausrichtung überwachen: Damit Argon nicht über die Absichten der Nutzer hinaus agiert, überwacht Google die Gedankengänge und Aktionen des Modells und stoppt Ausführungen im Zweifel. Ein ähnliches System habe bereits die Trainingsläufe begleitet und bei Auffälligkeiten ein eigenes Incident-Response-Team alarmiert. Google räumt ein, die Erkenntnisse bewusst nicht ins Training zurückfließen zu lassen, um zu verhindern, dass das Modell lernt, der Überwachung auszuweichen. Das Unternehmen ruft die Branche auf, die Transparenz von Modellgedanken in dieser Phase wachsender Fähigkeiten zu bewahren, damit Fehlausrichtungen erkennbar und diagnostizierbar bleiben.
Systeme härten: Da der sichere Test immer fähigerer Modelle entsprechend abgesicherte Umgebungen erfordert, härtet Google seine Sandbox-Umgebungen, indem es sie isoliert und versiegelt, bevor riskantes Training oder Evaluationen beginnen. Die erarbeiteten Praktiken zur Agentensicherheit will das Unternehmen mit Partnern teilen.
Preise und Verfügbarkeit
Argon startet zu einem Einführungspreis von 2 US-Dollar pro Million Eingabe-Token und 10 US-Dollar pro Million Ausgabe-Token; gecachte Eingaben kosten 95 Prozent weniger. Google spricht von einer Ausweitung des Zugangs „so bald wie möglich" – beginnend mit bezahlten API-Kunden und Abonnenten des Premium-Tarifs Google AI Ultra. Insgesamt soll das Modell Partner für Entwickler, Fachleute und Unternehmen bei den schwierigsten Problemen sein – von Coding und Wissensarbeit über Cyber-Abwehr bis zu kreativem Schreiben.
Zu beachten ist, dass die genannten Benchmark-Ergebnisse aus Googles eigener Produktankündigung stammen. Unabhängige Vergleiche durch Dritte stehen bislang noch aus.
Ein neues KI-Spitzmodell mit klarem Fokus auf IT-Sicherheit: Gemini 4 Argon von Google kann Software-Schwachstellen eigenständig aufdecken und beheben und soll auch bei Coding und Unternehmens-Workflows zur Spitze gehören. In mehreren Benchmarks schlägt es etablierte Konkurrenzmodelle, bleibt aber vorerst ausgewählten Testern vorbehalten. Später folgen API-Kunden und Google-AI-Ultra-Abonnenten.
Das Wichtigste in Kürze
Google hat mit Gemini 4 Argon ein neues KI-Spitzmodell angekündigt. Es soll komplexe, langlaufende Aufgaben in Softwareentwicklung, Wissensarbeit und Cybersicherheit bewältigen – mit einem Ausgabelimit von einer Million Token und laut Google führenden Werten in mehreren Benchmarks.
Die wichtigsten Zahlen und Punkte im Überblick
- Ausgabelimit: eine Million Token (zuvor 64.000)
- DeepSWE v1.1 (Coding): 77,9 Prozent – State of the Art
- Vals Index (Wissensarbeit): 68,9 Prozent – Rang eins
- Zapier AutomationBench (Workflows): 51,3 Prozent – Rang eins
- LVBench (lange Videos): 91,7 Prozent
- GraphWalks (Kontext bis 1 Million Token): 84,2 Prozent
- CWE-bench v1 (Schwachstellen beheben): 68 Prozent – geteilter erster Platz, gleichauf mit Grok 4.7
- Gray Swan IPI (Prompt-Injection-Robustheit): 0,7 Prozent Angriffsrate – das widerstandsfähigste Modell
- Einführungspreis: 2 US-Dollar pro Million Eingabe-Token, 10 US-Dollar pro Million Ausgabe-Token; gecachte Eingaben 95 Prozent günstiger
- Rollout: zunächst vertraute Cyber-Verteidiger, später bezahlte API-Kunden und Abonnenten von Google AI Ultra
Schwerpunkt ist die defensive Cybersicherheit: Argon kann Software-Schwachstellen eigenständig finden, validieren und beheben. Beim Sicherheitsanbieter Wiz deckte das Modell im Rahmen der Initiative „Scan for Good" bereits eine kritische Schwachstelle in weltweit genutzter Krankenhaus-Software auf, die frühere Modelle übersehen hatten.
Der Rollout erfolgt gestaffelt: Zunächst erhalten vertraute Cyber-Verteidiger über das Fairwind-Programm Zugang, später bezahlte API-Kunden und Abonnenten des Premium-Tarifs Google AI Ultra. Zu beachten bleibt, dass die Benchmark-Ergebnisse aus Googles eigener Produktankündigung stammen – unabhängige Vergleiche durch Dritte stehen bislang aus.

